苹果群控,是通过一台电脑对多台 iPhone 做集中管理与批量操作的技术方案,不越狱、不装插件、不需要开发板。
这篇要回答的是:苹果群控的号被限流了,第一个星期怎么处理。
有个做跨境小店的老板,去年冬天遇到过一次。
早上打开后台,三个店铺的曝光一起掉到了个位数。前一天还是四位数;三个店的账号在同一批设备上,走同一条网络。
他打电话过来的时候,问的第一个问题是「是不是被封了」。
我说先确认一件事:账号现在能不能正常登录、能不能正常发东西。他说能。
能登录、能发、就是没人看——这是限流,不是封号; 这两个词的处置方式完全不一样,而且限流往往就是封号的前一步。如果把限流当成「最近流量不好」放几周不管,大概率就走到下一步去了。
先停手,再按设备圈范围
这是反直觉的一条。
他的第一反应是去改配置:换网络、调参数、把觉得有问题的设备停下重配;我让他先别动,把所有设备上正在跑的任务全停掉。
停手的理由有两个。
一是继续操作会扩大痕迹。 如果你还没搞清楚原因,那么你在异常设备上做的每一步都可能是错的,而错的操作会留下新的记录。
二是你会毁掉对照组。 手上最值钱的东西,是那些还没出问题的设备和账号;它们是判断「问题出在哪儿」的唯一参照。一边排查一边继续跑,等回头再看,干净的那批也已经脏了,那还怎么归因?
所以第一天只做三件事:全停、记录、不动。
记录至少四样:
- 什么时候开始不正常的(数据下滑的时间点,和发现的时间点往往不是同一个)
- 涉及哪些设备、哪些账号(全部还是集中在某几台)
- 当时在跑什么任务、什么配置
- 最近一次改动是什么时候、改了什么
最后一条经常就是答案,但最容易被忽略,因为大家默认「昨天还好的」。
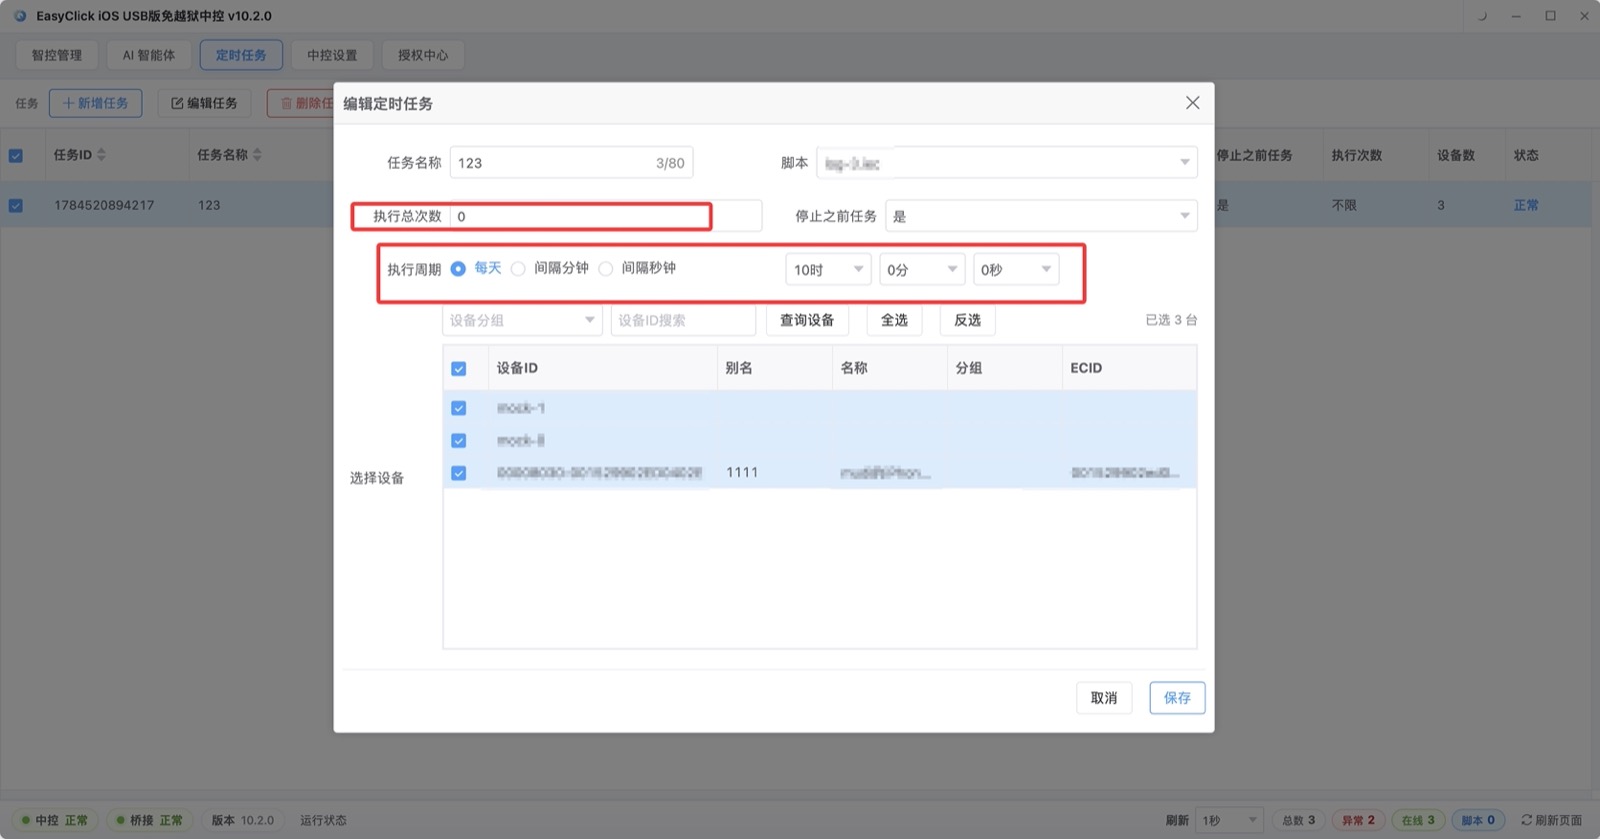
第二件事是圈范围。
按设备分,因为操作行为和硬件、网络是绑在一起的。
同一台设备上的几个账号,表现通常是一致的;同一个账号换到另一台设备上,往往是好的;按设备分组隔离,能一次圈定受影响范围。按账号分,你会把范围划错,因为账号是流动的,今天在 A 组设备上跑,明天可能被分到 B 组。
分完之后一般会看到四种情况,对应四种原因:
| 表现 | 更可能的原因 |
|---|---|
| 一个分组全部异常 | 这条网络出口或者这组设备的问题 |
| 分组内个别几台异常 | 单机问题(线材、接口、设备状态) |
| 全部设备都异常 | 内容或操作模式的问题,不是硬件 |
| 只有某类账号的所在设备异常 | 账号来源或账号本身的问题 |
找对照是这一步的关键。 同一批内容发在没出问题的设备上,如果表现正常,那问题偏向设备或网络;同样异常,那问题偏向内容。这一步的前提就是你第一天停手时保护下来的那批干净设备。
判断是内容还是操作
范围圈完之后,第三件事是分性质;这两种问题的处置方向是反的。
内容问题的表现是:换设备也没用,同样的内容在哪台设备上都表现差。这时候要做的是停掉这一类内容,而不是继续换设备试。很多人在这里反着来——「这条不行换一批设备再发一次」,换有用吗?没用,只会把新设备也带脏。
操作问题的表现是:内容本身没问题(在别的组表现正常),但在这组设备上就是不行。这时候方向是设备或环境。
还有第三种,也是最需要坦白说的一种:有些号就是救不回来的。
如果某个号在隔离之后、在干净设备上、换了内容之后,表现依然不行,那它已经很可能是被单独处理了。这时候正确的做法是放弃它,把资源留给还能用的号,而不是反复尝试把它拉回来。反复操作只会让它所在的设备也一起受影响。
这个判断很伤,尤其当那是个养了很久的号。但从时间成本上算,救一个大概率救不回来的号,代价是拖住一整组还能用的号。
恢复阶段别一次全放开
到了恢复阶段,最容易犯的错是一次全放开。
一次全放开的实质是:把处置期间攒下的所有待办操作,在同一时间点全部释放出去。 这制造出的操作密度,比出事之前还异常;结果就是刚恢复两小时又来一轮。
稳妥的做法是分三到四批:
- 第一批只放影响面最小、账号权重最稳的那几台,观察一个完整的业务周期
- 确认没有再次触发,再放第二批,规模可以稍大
- 恢复期间的操作密度要低于出事之前的日常水平,不要一上来就满负荷
- 哪一批又出现异常,立刻停,回到第二步重新归因
恢复慢一点不丢人;急着回到满负荷,通常要用第二次事故付学费。
最容易犯的三个错,和那位老板的结局
第一,边排查边继续操作。 最常见的。着急的心态压过流程,最后线索全毁,只能靠猜。
第二,把限流当成「最近流量不好」; 放几天再看。限流是有时效性的,观察窗口拖得越久,回旋余地越小。
第三,所有精力都扑在恢复上,没人去查最近改过什么。 应该同时有一个人专门回溯这批设备最近一周的变更:系统的、网络的、脚本的、任务排期的。大多数事故的根因就落在某一次看起来无关紧要的改动上。
回到那位老板。他那天按顺序走了一遍,最后查到的是:一周前换过一条宽带线路,新线路的出口和之前那批设备在同一个网段上。
他换了线路,分批恢复了三天,三个店都回来了。
被限流这件事,绝大多数不是「突然发生」的,是某个变化累积到阈值之上的结果。所以处置的终点不是「恢复正常」,而是知道它是怎么被触发的,那个原因如果还在,它会再来一次。
请确保使用场景本身合法合规。技术是中性的,边界在用法上。